什么都用最大的模型
连给邮件分类这样的简单任务,也交给最昂贵的模型。
大多数公司在AI上花了冤枉钱,AI出错时也察觉不到。我们先测量费用和错误从何而来,再同时解决:每项任务用合适的模型,减少每次请求的浪费,让回答以贵公司自己的文档为依据,并在使用前经过检查。
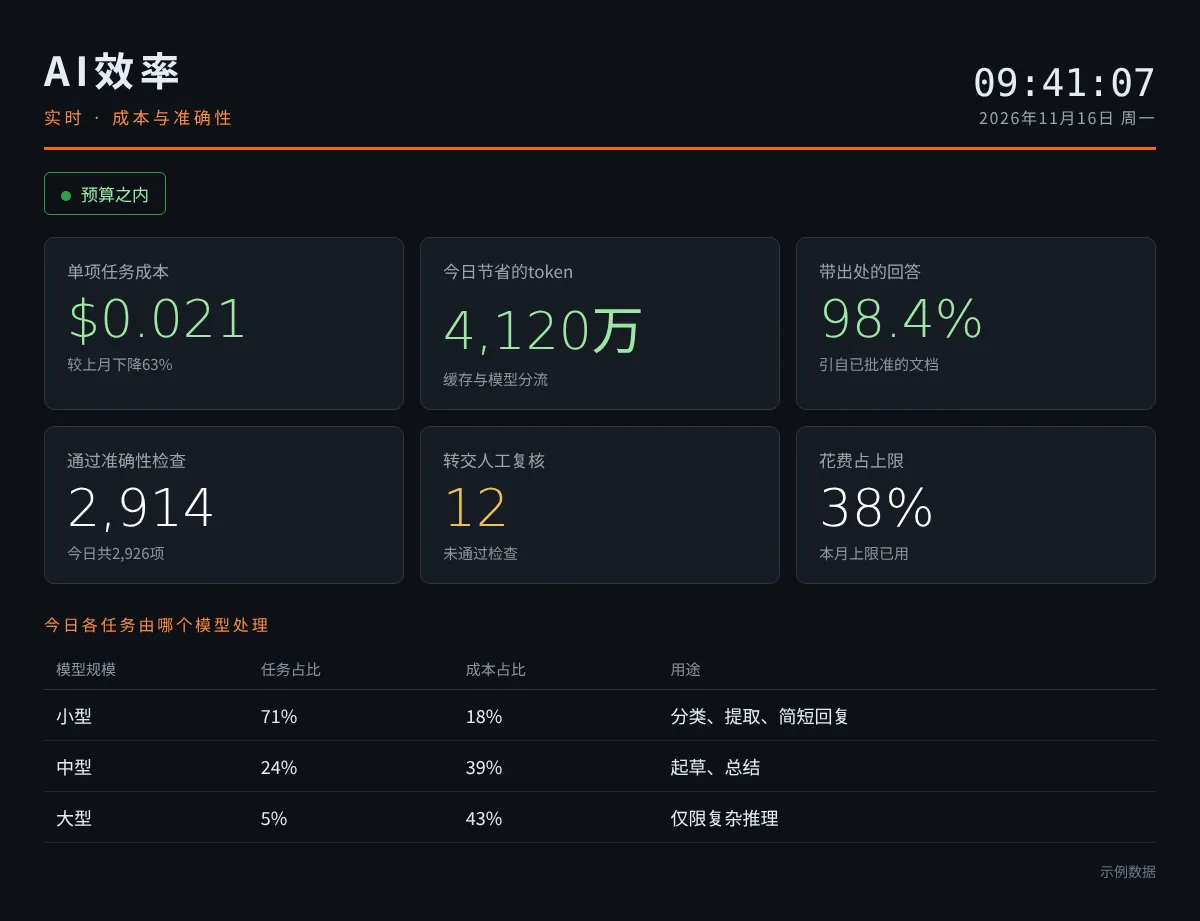
单个token的价格在下降,企业的AI账单却持续上涨。今年89%的企业因token成本缩减或重新设计了AI计划,只有27%的企业能非常准确地衡量AI成本(Cloudera,2026年)。另一个担忧是准确性:没有出处和检查,就无法知道AI什么时候答错了。
连给邮件分类这样的简单任务,也交给最昂贵的模型。
同样的长文件和指令每次请求都重新发送,每次都要付费。
听起来正确,却没有出处、没有检查,也没有生成过程的记录。
模型读取和输出的每个token都要付费。账单取决于用哪个模型、每次发送多少文本、同样的工作重复多少次,以及要尝试多少次才能得到可用的回答。
准确性也是同样的道理。凭记忆回答的模型是在猜测;依据贵公司已批准的文档回答、最后再经过检查的模型,才能拿出依据。
同样的任务,最大的模型可能比小模型贵好几倍。
每次请求发送的每一页文本都要计费。
重复运行同样的请求或重试失败的请求,会让账单成倍增加。
每项改动都会在前后进行测量,让您清楚看到节省了多少。
日常工作交给小而快的模型,最大的模型只用于真正需要它的任务。
重复使用的指令和文档会被缓存,无需每次按全价重新发送。
AI只从文档中提取相关段落,而不是每次都读取整份文件。
不需要即时回复的工作批量运行,服务商提供优惠价时即采用。
精简指令,回答只保留必要内容,减少输入和输出的token。
每个工作流程都有预算、实时计量,并在超支前发出提醒。
准确性要靠设计,而不是靠运气。
回答来自贵公司已批准的文档和数据,并注明出处,而不是依赖模型的记忆。
输出会与规则、格式和原文进行核对,未通过的内容会被标记,而不是直接发出。
合同、发给客户的消息和财务数字,在发出公司之前都由专人复核。
我们用贵公司的真实案例建立测试集,在上线前以及每次更换模型或指令后测量准确性。
没有完美的AI。目标是让您随时知道哪些回答经过检查、来自哪里、由谁批准。
| 改动 | 作用 | 适用于 |
|---|---|---|
| 模型分流 | 把每项任务交给能胜任的最小模型。 | 大量日常工作 |
| 缓存 | 不再为重复的指令和文档支付全价。 | 较长、反复使用的上下文 |
| 检索 | 只发送相关段落,而不是整份文件。 | 大量文档 |
| 私有AI | 用贵公司自己的算力成本取代按token计费。 | 用量大且稳定的业务、敏感数据 |
按工作流程、模型和部门实时显示花费。
在超支发生前加以阻止。
每个基于文档的回答都会显示依据。
用贵公司自己的案例衡量准确性。
记录每一次请求、回答、检查和审批。
随着模型和价格的变化不断调整。
审视贵公司目前的AI使用、账单和出问题的环节。
逐个流程说明成本和错误从何而来。
实施改动,并测量改动前后的成本和准确性。
随着用量、模型和价格的变化持续监控。
因为用量增长快于价格下降,而其中很多是浪费:简单任务也用最大的模型、每次请求都重发整份文档,以及反复重试。改进使用方式,通常比单价更重要。
只要任务匹配得当就不会。分类、提取和简短回复等日常工作,小模型完全胜任。切换前我们会用贵公司的案例测试,较大的模型保留给真正需要的任务。
我们用贵公司已知正确答案的真实案例建立测试集,在上线前和每次改动后,用它为每个模型和指令打分。
可以。基于贵公司文档的回答会显示所依据的段落,任何人都可以核实。
不需要。我们可以沿用您现在的服务商,也可以把工作迁移到私有AI,或两者结合。
第一步是测量,所以在任何改动之前,您就能看到钱花在了哪里。之后每项改动实施时都会核实节省效果。
告诉我们贵公司目前如何使用AI,我们会告诉您成本和错误从何而来。